Mysql实操

Mysql实操

一、与MySQL建立连接

1
2
3
4
5
6
7
8
# mysql -u用户 -p[密码] -P端口号 -h主机地址
mysql -uroot -p -P3306 -hlocalhost

# 修改初始密码
ALTER USER 'root'@'localhost' IDENTIFIED WITH mysql_native_password BY '新密码';

# 新建子账号
CREATE USER 'test'@'localhost' IDENTIFIED BY '123456';

二、库表操作

库操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
# 查看数据库
SHOW DATABASES;

# 新建数据库
CREATE DATABASE dbname;

# 删除数据库
DROP DATABASE dbname;

# 选中数据库
use dbname;

# 查看当前选中的数据库
select database();

# 查看建库语句
show create database dbname;

# 修改数据库
alter database dbname charset utf8;

# 备份数据库(初级)
备份:mysqldump -u用户名 -p 数据库名 > 存储路径\数据库名.sql
恢复:mysql -u用户名 -p 数据库名 < 存储路径\数据库名.sql

表操作

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
# 建表
create table 表名(
字段名1 类型[(宽度) 约束条件],
字段名2 类型[(宽度) 约束条件]
);

注意:
-在同一张表中,字段名是不能相同
-宽度和约束条件可选、非必须,宽度指的就是字段长度约束,例如:char(10)里面的10
-字段名和类型是必须的

举例 :
CREATE TABLE `student` (
`id` int(10) UNSIGNED NOT NULL AUTO_INCREMENT,
`name` varchar(50) NOT NULL DEFAULT '无名',
`age` int(10) UNSIGNED NOT NULL DEFAULT 0,
`id_number` varchar(18) NOT NULL DEFAULT '',
PRIMARY KEY (`id`)
)ENGINE=InnoDB DEFAULT CHARSET=utf8;

# 查看所有表
show tables;

# 查看建表语句
SHOW CREATE table_name;

# 查看表结构
SHOW COLUMNS FROM table_name; 或 DESC table_name

# 新增表字段: ALTER TABLE 表名 ADD 列名 数据类型;
ALTER TABLE `table_name`
ADD `sex` tinyint(2) UNSIGNED NOT NULL DEFAULT 1 COMMENT '性别 : 1:男 2:女' AFTER `id_number`; # COMMENT '性别 : 1:男 2:女' 表示该字段的注释说明

# 修改表
# 修改表名称
ALTER TABLE 旧的表名 RENAME TO 新的表名;
# 修改表字段类型
ALTER TABLE table_name MODIFY name char(10) NOT NULL DEFAULT '无名' AFTER id; # AFTER 跟在谁后面
#修改表字段名称
ALTER TABLE `table_name`
CHANGE `name` `new_name` char(50) CHARACTER SET utf8 COLLATE utf8_general_ci NOT NULL DEFAULT '无名' AFTER `id`;


# 删除表字段
ALTER TABLE `table_name`
DROP `sex`;

# 删除数据表
DROP TABLE table_name; # 谨慎,做备份

# 清空表
delete from table_name;
truncate table_name; #会将auto_increment的起始数据重置为1。

三、基础操作

增加

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
1. 插入完整数据(顺序插入)
语法一:
INSERT INTO 表名(字段1,字段2,字段3…字段n) VALUES(值1,值2,值3…值n); # 指定字段来插入数据,插入的值要和你前面的字段相匹配

语法二:
INSERT INTO 表名 VALUES (值1,值2,值3…值n); #不指定字段的话,就按照默认的几个字段来插入数据

2. 插入多条记录
语法:# 插入多条记录用逗号来分隔
INSERT INTO 表名 VALUES
(值1,值2,值3…值n),
(值1,值2,值3…值n),
(值1,值2,值3…值n);

3. 插入查询结果
语法:
INSERT INTO 表名(字段1,字段2,字段3…字段n)
SELECT (字段1,字段2,字段3…字段n) FROM 表2
WHERE …;
# 将从表2里面查询出来的结果来插入到我们的表中,但是注意查询出来的数据要和我们前面指定的字段要对应好

更新

1
2
3
4
5
UPDATE 表名 SET 字段1=值1,字段2=值2 WHERE CONDITION;

示例:
UPDATE mysql.user SET password=password(‘123’)
where user=’root’ and host=’localhost’;

查询

1
2
3
4
5
6
7
8
# 查询表中所有数据
SELECT * FEOM 表名;
# 查询指定条数
SELECT * FROM 表名 LIMIT 10;
# 查询指定起始位置条数的结果集
SELECT * FROM teacher LIMIT 10,10; #第11条开始后面10条
# 查询指定字段列的结果集
SELECT name,age FROM teacher LIMIT 6,5;

删除

1
2
3
4
5
6
7
8
9
# 删除符合条件的一些记录
DELETE FROM 表名 WHERE CONITION;
# 删除全部数据
DELETE FROM 表名;
# 清空全部数据
TRUNCATE TABLE 表名;

TRUNCATE 清空表数据的实际过程是先删除数据表,然后新建一张和原来表结构一模一样的表来替代清空。
DELETE 删除表数据不会改变自增主键的增长值

四、查询详解

1
2
3
4
5
6
7
SELECT * FROM 表名;这个SELECT * 指的是要查询所有字段的数据。
SELECT distinct 字段1,字段2... FROM 库名.表名
WHERE 条件 # 从表中找符合条件的数据记录,where后面跟的是你的查询条件
GROUP BY field(字段) # 分组
HAVING 筛选 # 过滤,过滤之后执行select后面的字段筛选,确定一下需要哪个字段的数据,查询的字段数据进行去重,然后在进行下面的操作
ORDER BY field(字段) # 将结果按照后面的字段进行排序
LIMIT 限制条数 # 将最后的结果加一个限制条数,就是说我要过滤或者说限制查询出来的数据记录的条数

WHERE条件

符号 说明 举例
< 小于,< 左边的值如果小于右边的值,则结果为 TRUE,否则为 FALSE 如 : 满足年龄小于 18 的条件 age < 18
= 等于,= 左边的值如果等于右边的值,则结果为 TRUE,否则为 FALSE 如 : 姓名为 小明 的条件 name = '小明'
> 大于,> 左边的值如果大于右边的值,则结果为 TRUE,否则为 FALSE 如 : 时间戳大于 2020-03-30 00:00:00的条件 time > 1585497600
<> 不等于,<>还可写成 != ,左边的值如果不等于右边的值,则结果为 TRUE,否则为 FALSE 如 : 年份不等于2012的条件 year !=year <> 2012
<= 小于等于,<= 左边的值如果大于右边的值,则结果为 FALSE,否则为 TRUE 如 : 满足年龄小于等于 18 的条件 age <= 18
>= 大于等于,>= 左边的值如果小于右边的值,则结果为 FALSE,否则为 TRUE 如 : 满足年龄大于等于 18 的条件 age >= 18
LIKE 模糊条件,LIKE 右边的值如果包含左边的值,则结果返回TRUE,否则为 FALSE 如 : 满足身份证号为 420 开头的条件 id_number LIKE '410%',其中 % 表示任意值
NOT LIKE 不满足模糊条件,LIKE 右边的值如果不包含左边的值,则结果返回TRUE,否则为 FALSE 如 : 满足身份证号不是 X 结尾的条件 id_number NOT LIKE '%X',其中 % 表示任意值
BETWEEN AND 在两个值之间(包含两端值) 如 : 年龄满足 大于等于20 和 小于等于30 的条件 age BETWEEN 20 AND 30
NOT BETWEEN AND 不在在两个值之间(不包含两端值) 如 : 年龄满足 小于20 和 大于30 的条件 age NOT BETWEEN 20 AND 30
IS NULL 空,IS NULL 左边的值如果为空,则返回TRUE,否则为FALSE 如 : 年龄满足 邮箱为空 的条件 email IS NULL
IS NOT NULL 不是空,IS NOT NULL 左边的值如果不为空,则返回TRUE,否则为FALSE 如 : 年龄满足 邮箱不为空 的条件 email IS NOT NULL

LIKE 模糊查询

1
2
3
4
5
# %表示任意多字符   
# _表示一个字符
SELECT * FROM student WHERE name LIKE '王%';
# 实际业务中如非必要尽量避免使用模糊查询,如果必须要用,尽量选择最左匹配原则,因为这样可以使用到索引,形如 '王%' 这种格式,否则一旦数据量很大,没有用到索引的模糊查询性能可能会很差

AND多条件查询

1
2
SELECT * FROM student WHERE age > 18 AND name LIKE  '王%';

OR多条件查询

1
2
SELECT * FROM student WHERE age > 18 OR name LIKE  '王%';

NULL查询

查询字段为 NULL 的结果集要写成 字段 IS NULL,而不能使用 字段=NULL

UNION 联合查询

1
2
3
4
5
# 把两个查询结果聚集到一起
SELECT * FROM student WHERE age > 20
UNION
SELECT * FROM student WHERE age > 25;

GROUP BY分组

1
2
3
select post,count(id) as count from employee group by post;
#按照岗位分组,并查看每个组有多少人,每个人都有唯一的id号,我count是计算一下分组之后每组有多少的id记录,通过这个id记录我就知道每个组有多少人了

使用 GROUP BY 分组时,要将 MySQL 的 sql model 配置中 ONLY_FULL_GROUP_BY 的值去除掉,如果有该 sql_model 配置,在 SELECT 中的列,没有在 GROUP BY 中出现,那么这个 SQL 是不合法的

SELECT @@sql_mode;查看是否有ONLY_FULL_GROUP_BY

若想要配置 sql_mode 则可以在 MySQL 配置文件中 [mysqld] 下面增加 sql_model,设置好之后,重启 MySQL

sql_mode='STRICT_TRANS_TABLES,NO_ENGINE_SUBSTITUTION'

HAVING过滤

1
2
3
4
5
6
7
8
9
10
having的语法格式和where是一模一样的,只不过having是在分组之后进行的进一步的过滤,where不能使用聚合函数,having是可以使用聚合函数的

执行优先级从高到低:where > group by > having

Where 发生在分组group by之前,因而Where中可以有任意字段,但是绝对不能使用聚合函数。
Having发生在分组group by之后,因而Having中可以使用分组的字段,无法直接取到其他字段,having是可以使用聚合函数

举例:
select post,avg(salary) as new_sa from employee where age>=30 group by post having avg(salary) > 10000;

聚合函数

MySQL 主要的聚合函数有 AVG、COUNT、SUM、MIN、MAX

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
SELECT AVG(salary) FROM employee; # 平均值
SELECT COUNT(*) FROM employee; # count是统计个数用的
SELECT COUNT(id) FROM employee;
SELECT SUM(salary) FROM employee; # 总和
SELECT MIN(salary) FROM employee; # 最小值
SELECT MAX(salary) FROM employee; # max()统计分组后每组的最大值,没有写group by,就是统计整个表中所有记录中薪资最大的值

补充:CONCAT() 函数用于连接字符串
SELECT CONCAT('姓名: ',name,' 年薪: ', salary*12) AS new_salary FROM employee;
#看结果:通过结果你可以看出,这个concat就是帮我们做字符串拼接的,并且拼接之后的结果,都在一个叫做new_salary的字段中了
+---------------------------------------+
| new_salary |
+---------------------------------------+
| 姓名: zhangsan 年薪: 87603.96 |
| 姓名: lisi 年薪: 12000003.72 |
| 姓名: wangermazi 年薪: 99600.00 |
.....
+---------------------------------------+

DISTINCT去重

1
2
select count(distinct post) from employee;

ORDER BY排序

1
2
3
4
5
SELECT * FROM employee ORDER BY salary; #默认是升序排列
SELECT * FROM employee ORDER BY salary ASC; #升序
SELECT * FROM employee ORDER BY salary DESC; #降序
SELECT * FROM employee ORDER BY age ASC,salary DESC; # 多字段排序

LIMIT限制查询的记录

1
2
3
4
5
6
# 查询指定条数
SELECT * FROM employee ORDER BY salary DESC LIMIT 10;
# 查询指定起始位置条数的结果集
SELECT * FROM employee ORDER BY salary DESC LIMIT 10,10;
# 第11条开始后面10条

正则匹配查询

1
2
3
4
5
6
7
8
9
10
11
12
13
SELECT * FROM employee WHERE name REGEXP '^zh'; # 以什么开头
SELECT * FROM employee WHERE name REGEXP 'on$'; # 以什么结尾

# 常用的几个
1.匹配手机号
^1([38][0-9]|4[579]|5[0-3,5-9]|6[6]|7[0135678]|9[89])\d{8}$
2.匹配域名网址
^(?=^.{3,255}$)(http(s)?:\/\/)?(www\.)?[a-zA-Z0-9][-a-zA-Z0-9]{0,62}(\.[a-zA-Z0-9][-a-zA-Z0-9]{0,62})+(:\d+)*(\/\w+\.\w+)*$
3.匹配邮箱
^[a-zA-Z0-9_-]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)+$
4.匹配日期+时间
^[1-9]\d{3}-(0[1-9]|1[0-2])-(0[1-9]|[1-2][0-9]|3[0-1])\s+(20|21|22|23|[0-1]\d):[0-5]\d:[0-5]\d$

JOIN连表查询

LEFT JOIN 左连接

LEFT JOIN 为左连接,是以左边的表为’基准’,若右表没有对应的值,用 NULL 来填补。

RIGHT JOIN 右连接

RIGHT JOIN 为右连接,是以右边的表为’基准’,若左表没有对应的值,用 NULL 来填补。

INNER JOIN 内连接

INNER JOIN 为内连接,展示的是左右两表都有对应的数据。

1
2
select employee.id,employee.name,department.name as depart_name from employee left join department on employee.dep_id=department.id;

全外连接

mysql不支持全外连接 full JOIN,可以使用union联合查询的方式间接实现全外连接

条件判断函数

MySQL 提供的 IF、IFNULL、CASE 三种条件判断函数或结构,条件判断是为了实现控制流,在不同的条件下执行不同的流程

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# IF
SELECT name,IF(age > 17,'成年','未成年') AS age_group,id_number FROM student;
# IF(age > 17,'成年','未成年') 表示若 age 字段满足 age > 17 则展示为 成年,否则展示为 未成年

# IFNULL
SELECT name,age,id_number,IFNULL(email,'default@qq.com') AS full_email FROM student;
# IFNULL(email,'default@qq.com') 表示若 email 字段为 NULL ,则展示为 default @qq.com

# CASE
SELECT *,
CASE name
WHEN 'Tom' THEN '汤姆'
WHEN 'Jack' THEN '杰克'
WHEN 'Mary' THEN '玛丽'
FROM student;
# 对 name 字段进行条件判断,并将判断后的列重命名为 chinese_name,若指定的 name 字段的值满足 WHEN 则展示相应的 THEN 后面的值

五、常见的MySQL数据类型

MySQL数据类型

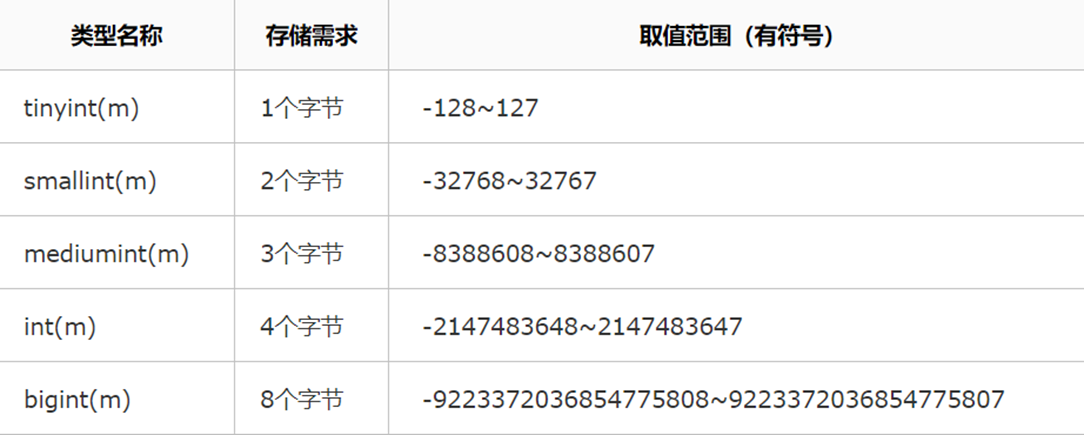
整型

1574776065328

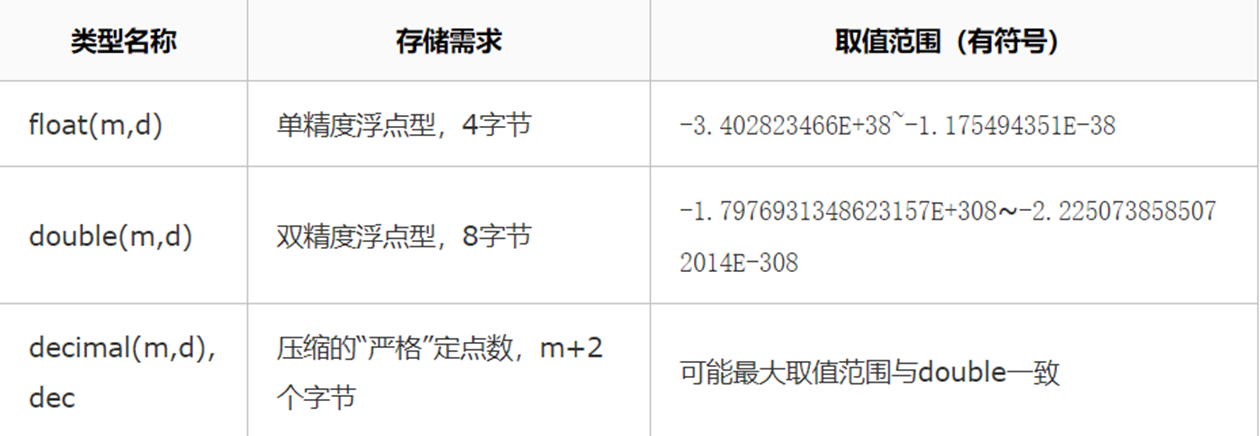
浮点型

1574776158003

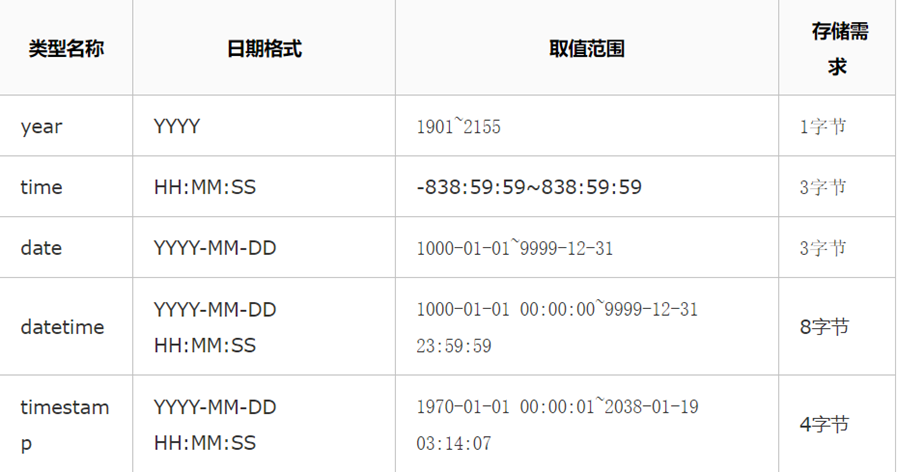
日期

1574776199377

字符串

类型名称 取值范围 需求
char 最多255个字符 定长存储
vachar 最多65535个字符 变长存储

枚举与集合

类型名称 取值
枚举 enum(值,[值]) 单选
集合 set(值,[值]) 多选

六、实践练习

建如下两张表并写入数量足够的测试数据:

部门表(dept):包含部门编号和部门名称字段

雇员信息表(emp):包含部门编号、员工工号、员工姓名、具体职务、直接上级、月薪,要求部门表和雇员信息表为一对多关系

(1)列出emp表中各部门的部门号,最高工资,最低工资(可分开写)
(2)列出emp表中各部门job为’销售’的员工的最低工资,最高工资
(3)对于emp中最低工资小于2000的部门,列出job为’销售’的员工的部门号,最低工资,最高工资
(4)根据部门号由高而低,工资由低而高列出每个员工的姓名,部门号,工资(由高到低和由低到高分开写)
(5)对于工资高于本部门平均水平的员工,列出部门号,姓名,工资,按部门号排序

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
CREATE TABLE dept(
dept_id INT PRIMARY KEY AUTO_INCREMENT,
dept_name VARCHAR(32) NOT NULL
)CHARSET = utf8;

CREATE TABLE emp(
user_id INT PRIMARY KEY AUTO_INCREMENT,
dept_id INT NOT NULL,
user_name VARCHAR(20) NOT NULL,
duties VARCHAR(20) NOT NULL,
superior VARCHAR(20) NOT NULL,
salary FLOAT(10,2) NOT NULL
)CHARSET= utf8;

INSERT dept VALUE(0,"研发部"),(0,"人事部"),(0,"后勤部"),(0,"教学部"),(0,"财务部");

INSERT emp VALUE(0,1,'zhan','教研','self',120000),
(0,2,'七七','销售','CEO',10000),
(0,4,'小六','销售','CEO',6000),
(0,3,'二蛋','保安','奎哥',8000),
(0,3,'三毛','保安','奎哥',8000),
(0,1,'jarvis','教研','CEO',100000),
(0,3,'刘姨','保洁','奎哥',7000),
(0,5,'小丽','财务','CEO',10000),
(0,2,'梦圆','人员调动','CEO',8500);
-- INSERT emp VALUE(0,2,'狗蛋','看大门','二蛋',300);
-- 1
SELECT b.dept_name,MAX(a.salary),MIN(a.salary) from emp AS a JOIN dept AS b ON a.dept_id = b.dept_id GROUP BY b.dept_name;

-- 2
SELECT b.dept_name,a.duties,MAX(a.salary),MIN(a.salary) from emp AS a JOIN dept AS b ON a.dept_id = b.dept_id AND duties="销售" GROUP BY b.dept_name;
-- 3

SELECT b.dept_name 部门,MAX(a.salary) 最高月薪,MIN(a.salary) 最低月薪
from emp AS a
JOIN (SELECT DISTINCT e.dept_id,d.dept_name
FROM emp as e
JOIN dept as d
ON e.dept_id = d.dept_id
WHERE salary < 2000) as b
ON a.dept_id = b.dept_id
WHERE a.duties="销售"
GROUP BY a.dept_id;


-- SELECT emp.dept_id,salary
-- FROM emp
-- JOIN dept
-- ON emp.dept_id = dept.dept_id
-- WHERE salary < 2000;

-- 4
SELECT a.user_name,b.dept_name,a.salary FROM emp AS a JOIN dept AS b ON a.dept_id = b.dept_id ORDER BY b.dept_id DESC;
SELECT a.user_name,b.dept_name,a.salary FROM emp AS a JOIN dept AS b ON a.dept_id = b.dept_id ORDER BY a.salary;

-- 5
SELECT d.dept_name,user_name,salary
FROM emp AS e
JOIN dept AS d
ON e.dept_id = d.dept_id
WHERE e.salary > (SELECT AVG(e1.salary) from emp e1 WHERE e.dept_id=e1.dept_id)
ORDER BY d.dept_name;
都看到这里了,不赏点银子吗^v^